Agentenbasierte KI · 2026
Destillierte Modelle für einen schnelleren, günstigeren hybriden KI-Agenten
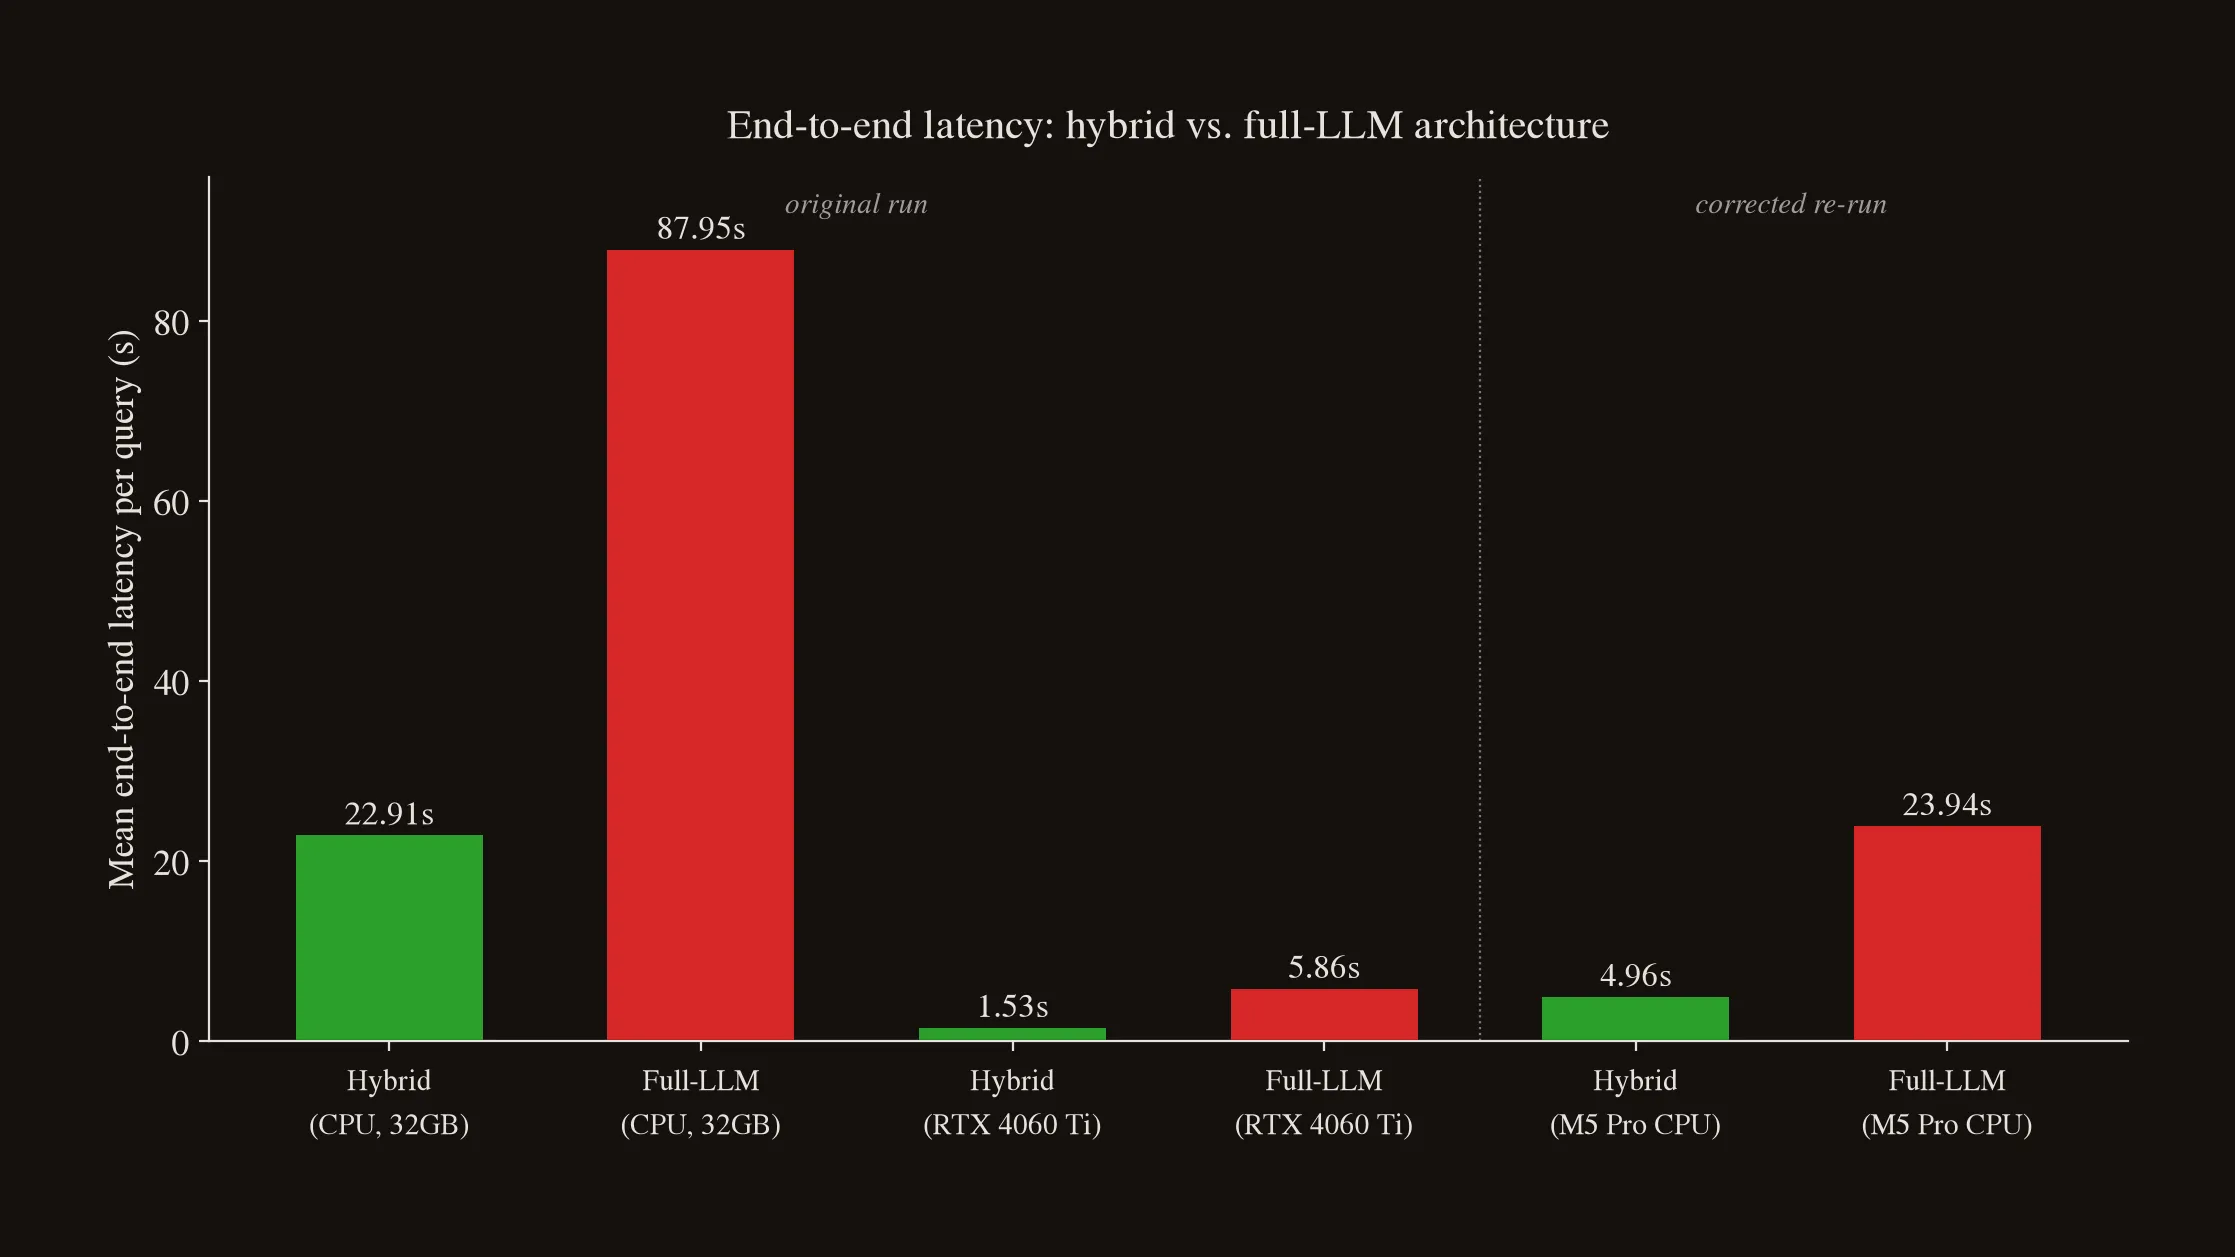
Ein hybrider Agent, der 3,8- bis 4,8-mal schneller antwortet als ein reiner Cloud-Agent, zu halben Cloud-Kosten, und die Datenzeilen in der eigenen Infrastruktur behält.
Kurz gesagt
Agenten, die Was-wäre-wenn-Fragen zu tabellarischen Daten beantworten, rufen pro Antwort ein Vorhersagemodell viele Male auf. Ein tabellarisches Foundation Model (TabPFN) braucht auf einer CPU 12,6 s pro Vorhersage, zu langsam für einen mehrstufigen Agenten, und ein Agent, der vollständig auf einem Cloud-LLM läuft, schickt sensible Daten an eine externe API. Die Frage war, wie viel der Arbeit in die eigene Infrastruktur wandern kann, ohne an Antwortqualität zu verlieren.
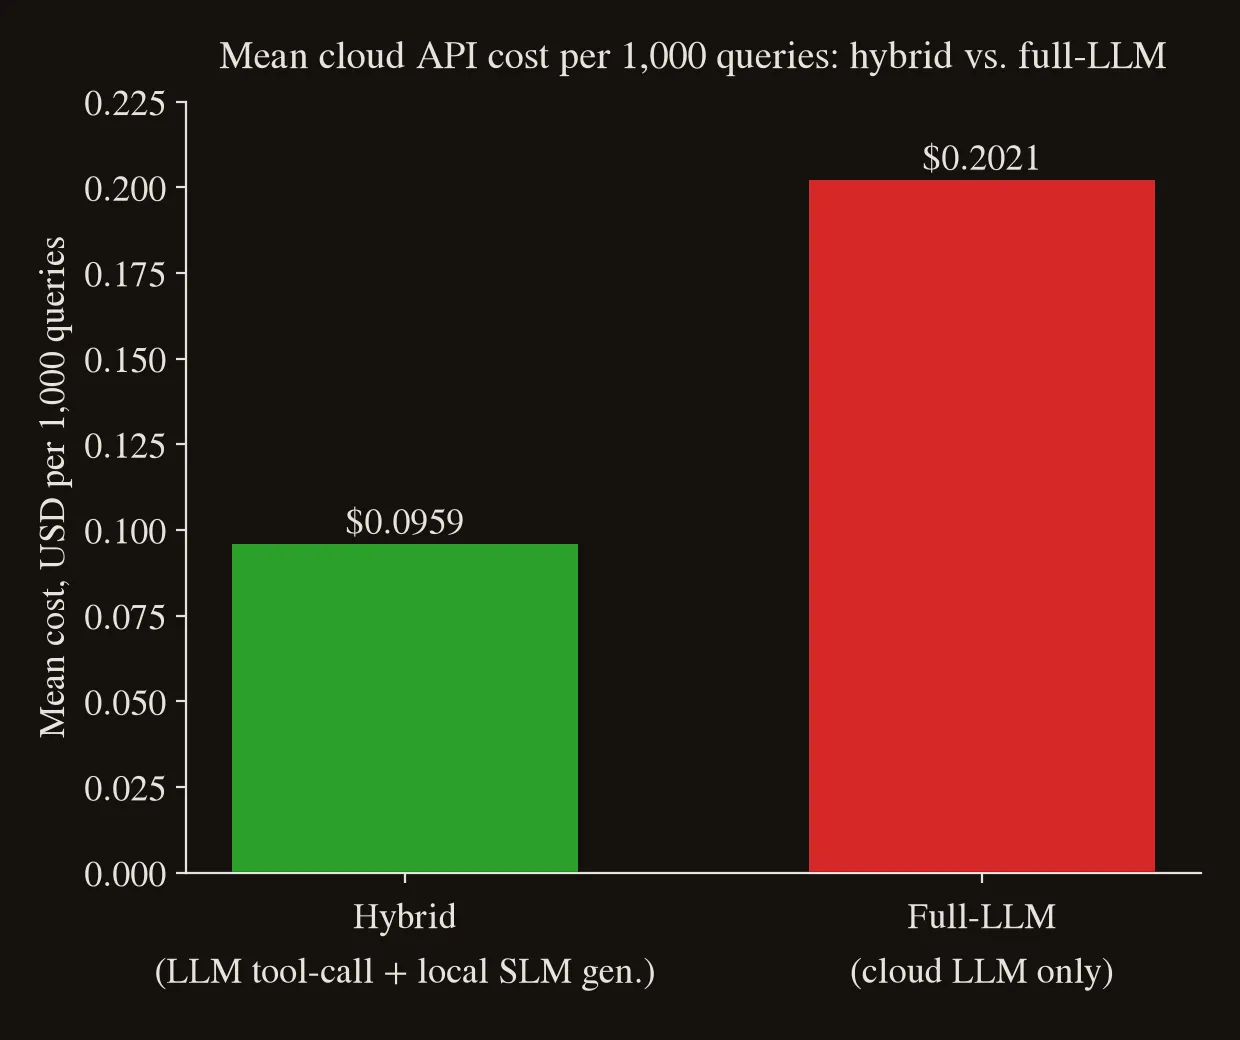 Ein schemagebundener Cloud-Aufruf pro Anfrage halbiert die Token-Rechnung.
Wie
- Hybrider Agent: Ein einziger Cloud-LLM-Aufruf (gpt-4o-mini) wählt das Tool und zerlegt die Frage; ein aus TabPFN destilliertes Modell macht die Vorhersage, und ein lokales Qwen2.5-3B-Modell schreibt die Antwort, beides in der eigenen Infrastruktur.
- Destilliertes Modell: ein MLP mit 17.059 Parametern, das über sechs Datensätze 95 bis 100 % der Genauigkeit von TabPFN behält und fast die gesamte Beschleunigung trägt.
Details und vollständige Ergebnisse im Preprint, arXiv:2609.16091 (Sourish Dey und Aditya Kumar, 2026), nicht begutachtet.