Angewandte KI · seit 2025
TracEx
Jede Zahl, die aus einer Publikation gezogen wird, trägt den genauen Satz, aus dem sie stammt, und eine Note dafür, wie gut diese Prüfung hält.
Kurz gesagt
Messwerte in materialwissenschaftlichen Publikationen stecken im Fließtext: Einen einzelnen Parameter zu finden hieß, das PDF zu lesen und die Zahl von Hand abzuschreiben. Ein einfacher LLM-Aufruf oder ein allgemeines KI-Werkzeug liefert Ergebnisse voller Halluzinationen. Was fehlte, war eine Extraktion, bei der jede Zahl auf den genauen Satz zurückführt, aus dem sie stammt.
Pythondoclingpymatgenquantulum3litellmpytestLLM-Tool-NutzungJSON Schema
Wie
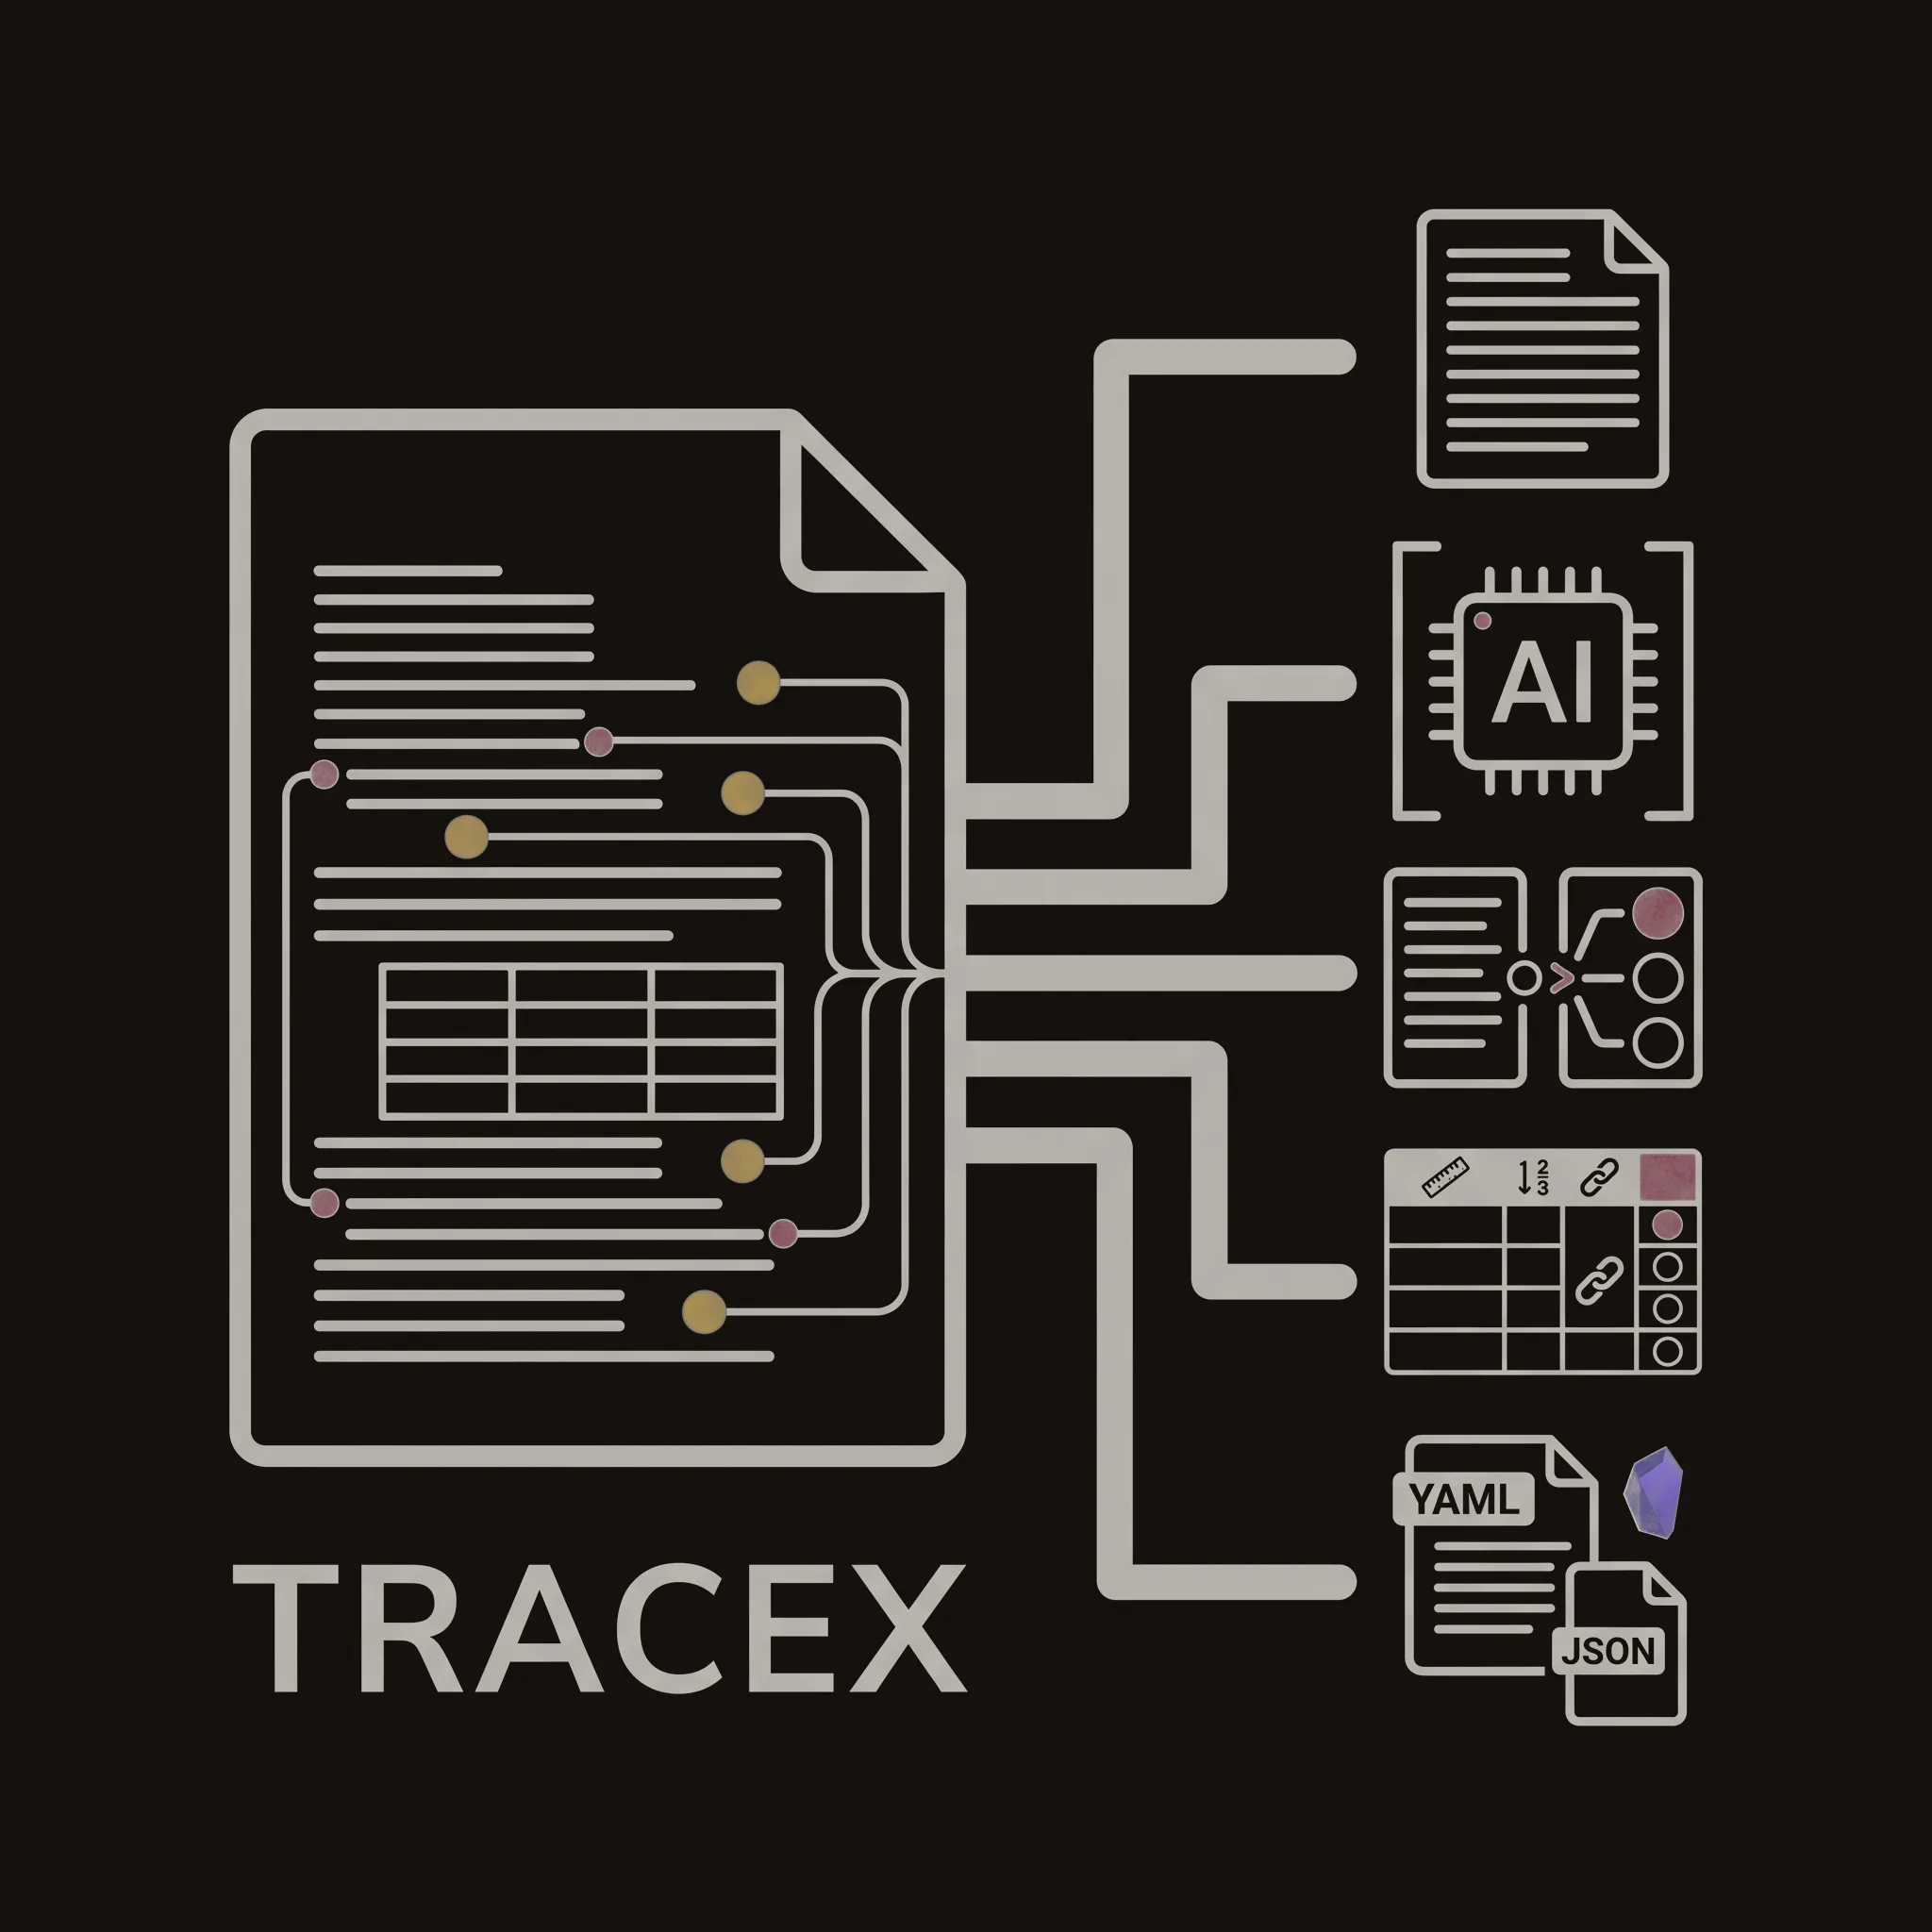
- Die Herkunft vor der Extraktion vermerkt. docling zerlegt das PDF, und jeder Satz und jede Tabellenzelle erhält eine hierarchische ID, bevor ein LLM läuft, sodass jede Aussage an einem festen Textanker hängt.
- Zuerst deterministisch extrahiert: reguläre Ausdrücke, pymatgen zur Prüfung chemischer Formeln und quantulum3, erweitert um ein Einheitenverzeichnis aus der Festkörperphysik, für Zahlen und Einheiten. Erst danach folgt ein LLM-Aufruf pro Publikation, mit erzwungener Tool-Nutzung gegen ein JSON-Schema und einem festen Budget an Aufrufen.
- Den Modellanbieter austauschbar gehalten, über litellm, für Anthropic, OpenAI und Gemini.
- Jeden Wert danach deterministisch benotet: Die vom LLM zitierten Satz-IDs werden gegen den Originaltext geprüft, mit Teilstring-Abgleich von Alias-Namen für Probenbezeichnungen und regulären Ausdrücken mit Wortgrenzen für Zahlen, woraus die Note A, B oder C folgt.
- Eine Obsidian-Markdown-Notiz pro Probe geschrieben, mit einer Messwerttabelle samt Quellenlinks und Noten, dazu JSON-Artefakte für jede Stufe. Getestet mit pytest.
Derselbe Ansatz, erst vermerken, dann prüfen, liegt der Literatursuche des Labors zugrunde.