Agentic RAG · seit 2026
Agentic RAG für eine Fachliteratur
Die Literatur eines Labors mit über 10.000 Publikationen, durchsuchbar für KI-Agenten, jede Antwort auf die Textstelle zurückgeführt, aus der sie stammt.
Kurz gesagt
Die Literatur eines Labors zu durchsuchen hieß bisher: Stichwortsuche, die den Sinn verfehlt, oder ein KI-Chatbot, der seine Zitate erfindet. Physikalische Publikationen sind schwer zu durchsuchen: Zentrale Ergebnisse stecken in Abbildungen, das Argument läuft über Gleichungen, und viel von der Bedeutung eines Satzes liegt in der Quelle, die er zitiert. Das Labor brauchte Antworten, die sich auf eine bestimmte Textstelle in einer bestimmten Publikation zurückführen lassen.
Gebaut in der Taskforce KI und Digitalisierung des Kläui Lab, die ich leite, neben der Wiki-Suche, die derselbe Chatbot nutzt. Der Ansatz zur Überprüfung stammt aus TracEx.
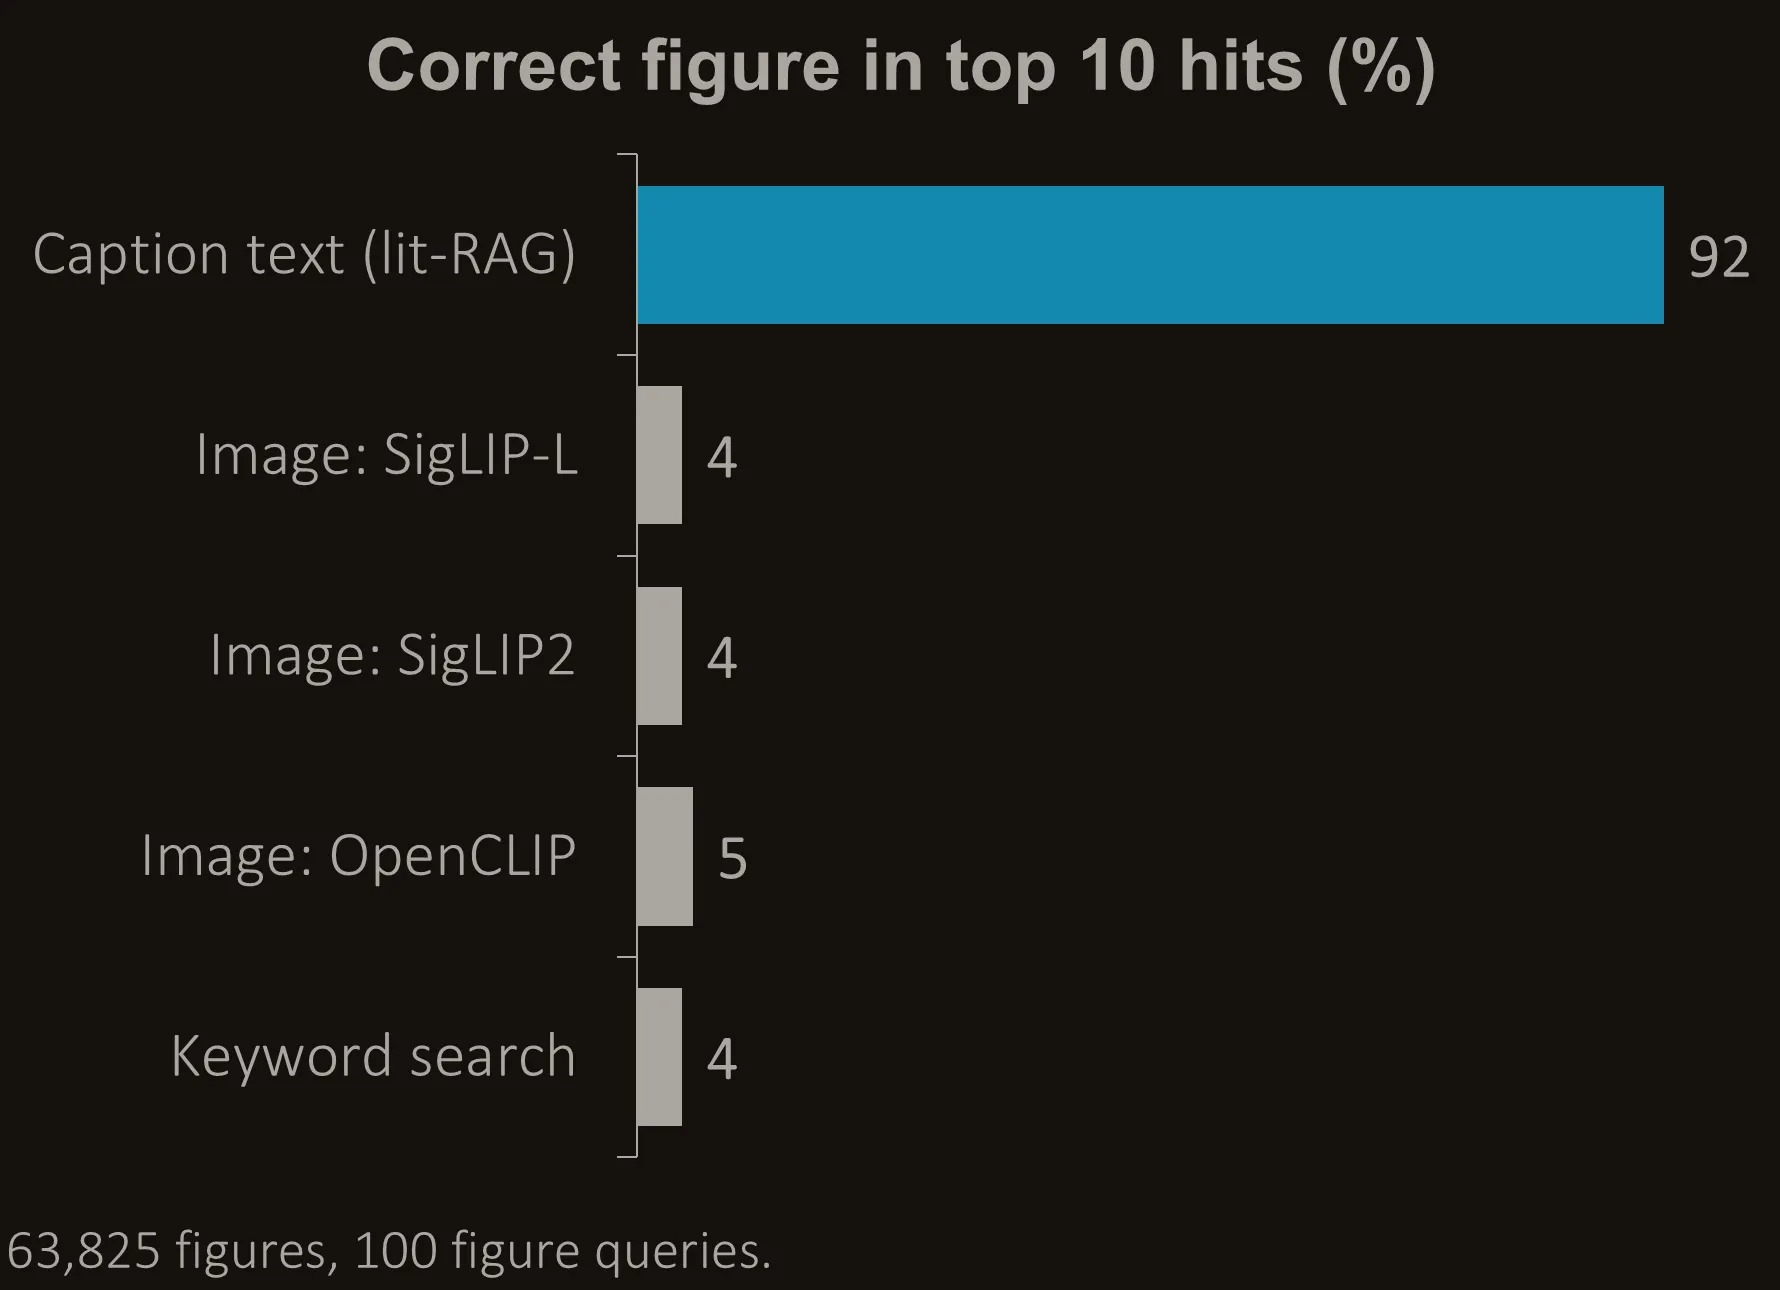 Die Suche im Bildunterschriftentext findet die richtige Abbildung bei 92 % der Fragen unter den ersten 10; Bild-Embeddings schaffen 4 bis 5 %.
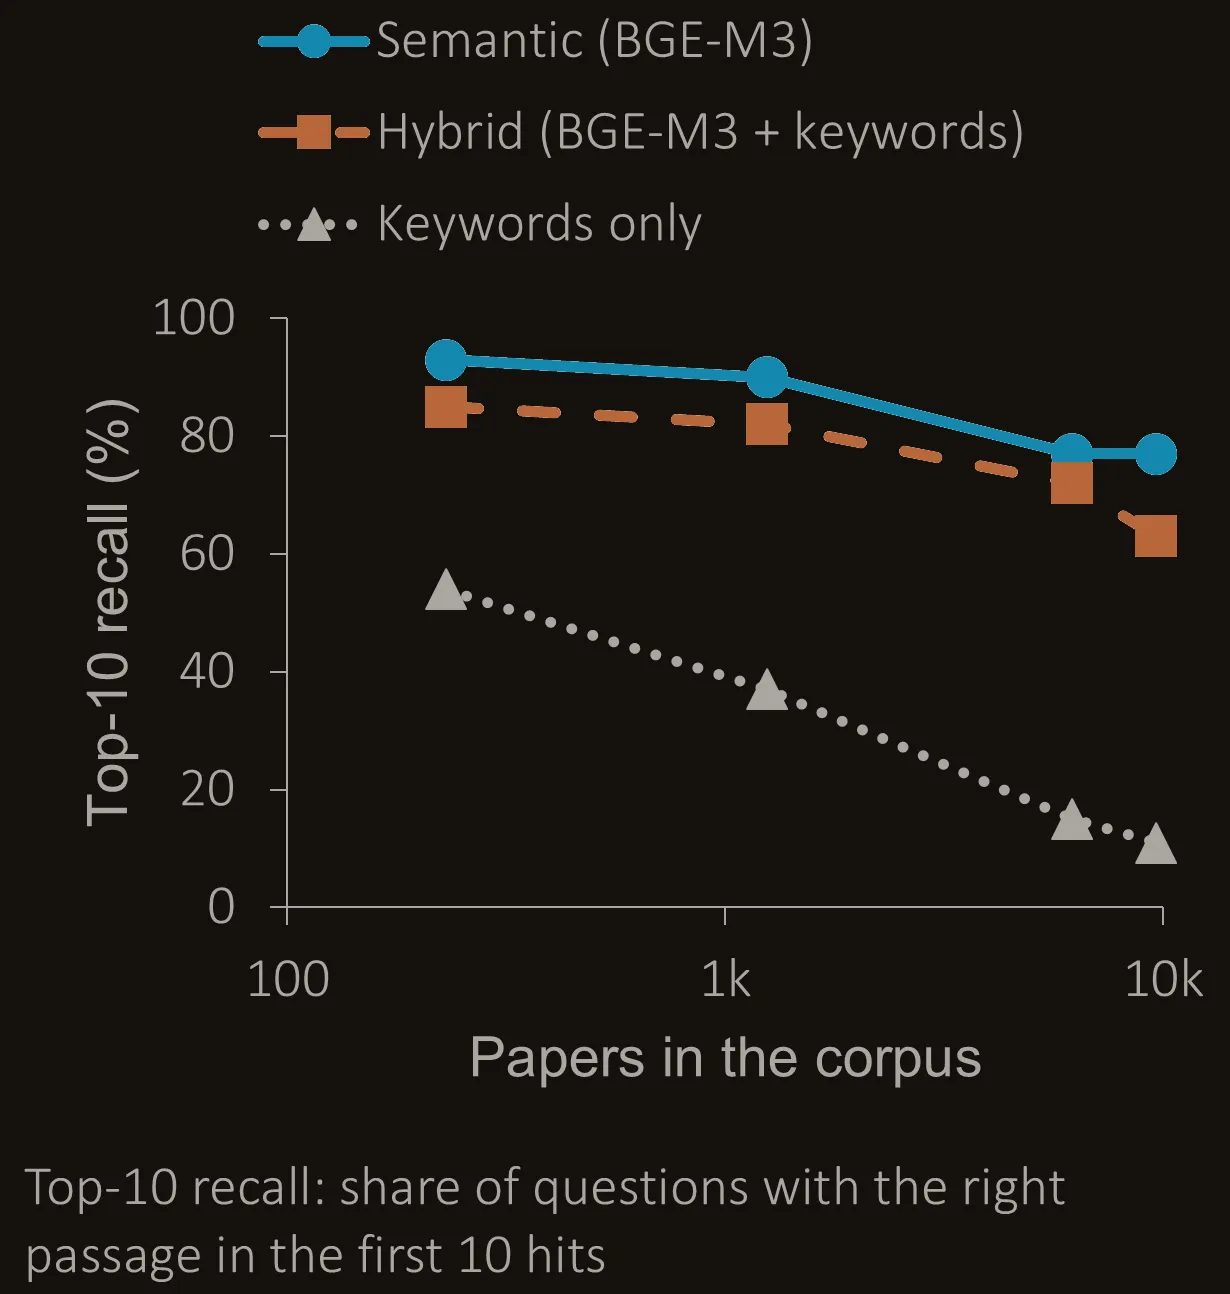 Wächst der Korpus auf 10.000 Publikationen, hält die semantische Suche 77 %, während die Stichwortsuche auf 11 % einbricht.
Wie
- Jede Publikation in einen Baum aus Blöcken zerlegt, mit Docling, GROBID und CrossRef: Abschnitte, Absätze, Abbildungen mit Bildunterschriften, Gleichungen und Literaturangaben, jeweils mit Position auf der Seite. Jede Textstelle speichert den Hash ihrer Quelle, den Checkpoint des Embedding-Modells und die Parser-Version, sodass sich eine Antwort auf die genaue Datei und den genauen Pipeline-Lauf zurückführen lässt.
- Einen agentenbasierten Retriever gebaut. Ein KI-Agent führt eine semantische Suche über Textstellen von etwa 500 Tokens aus, eingebettet mit BGE-M3 in PostgreSQL mit pgvector, folgt dann den Zitaten im Gefundenen oder wandert durch den Zitationsgraphen um eine Publikation.
- Abbildungen über ihren Bildunterschriftentext indiziert, ohne eingebettete Pixel und ohne Bildmodell; genau das hat die Bild-Embeddings oben geschlagen.
- Das übliche hybride Rezept verworfen, als die Evaluation es nahelegte. Der Recall@10 der Stichwortsuche fiel von 0,54 auf 0,11, als der Korpus von 230 auf 9.642 Publikationen wuchs, und über 13 Konfigurationen wurde der Gewinn durch das Einmischen von Stichwörtern in die semantische Suche negativ. Die Volltextsuche von PostgreSQL dient jetzt nur noch als Filter. Beide Goldstandards wurden generiert und adversarial überprüft, ohne Handannotation.
- Als MCP-Server bereitgestellt mit sechs Tools (
search,get_paper,follow_citation,graph_walk,get_figures,report_issue), die eine Enthaltung als strukturierte Daten zurückgeben. Die CI führt die Prüfsuite bei jedem Push aus, und eine festgeschriebene Retrieval-Baseline lässt den Build bei einer Verschlechterung scheitern.
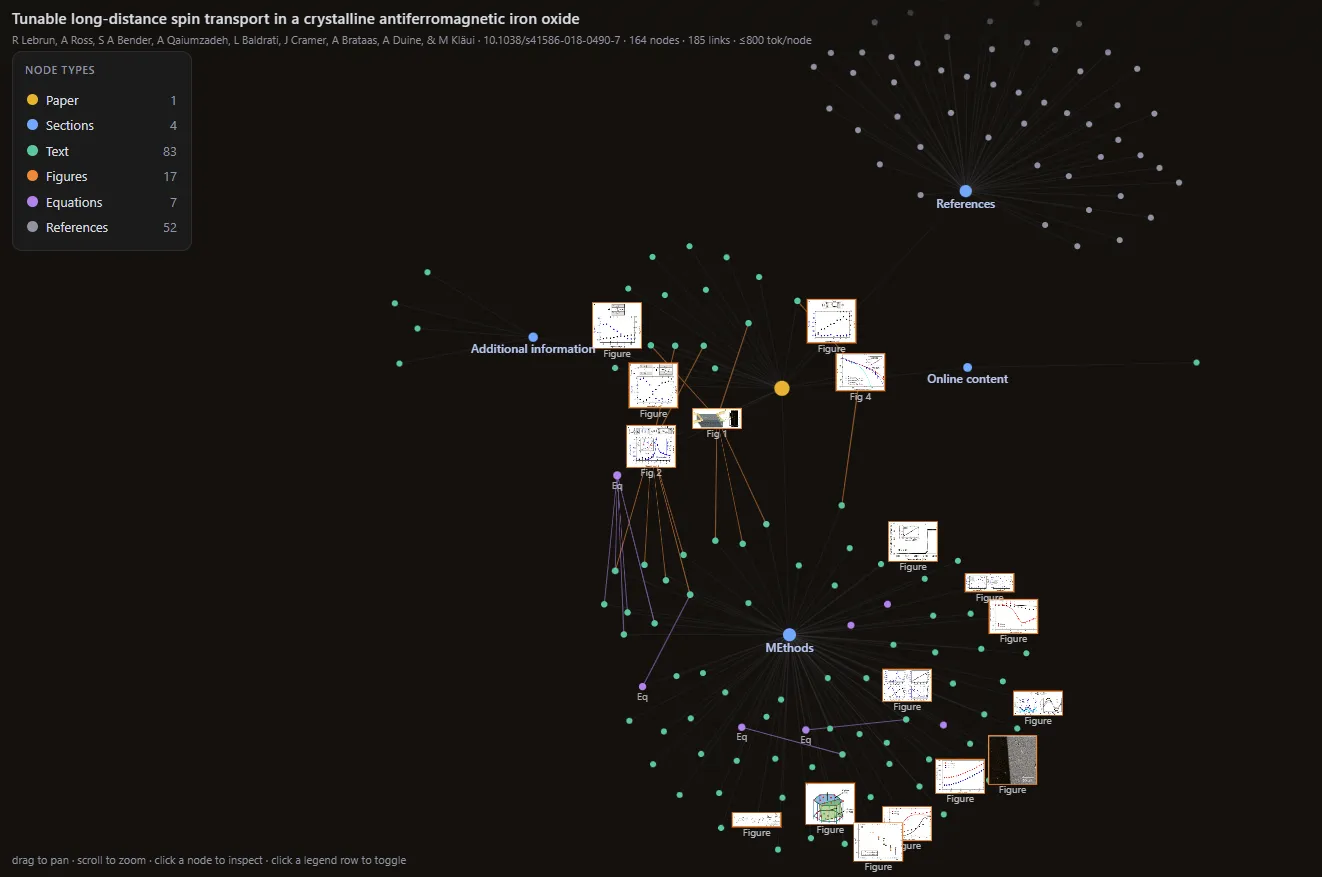 Eine Publikation, wie der Parser sie sieht: 164 Knoten und 185 Verknüpfungen, jede Abbildung mit dem Text verbunden, der sie zitiert.
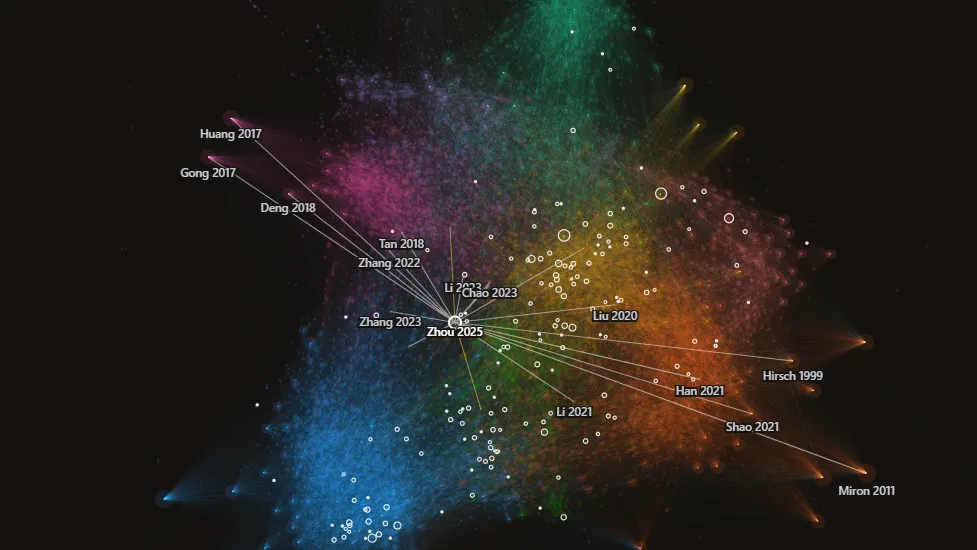
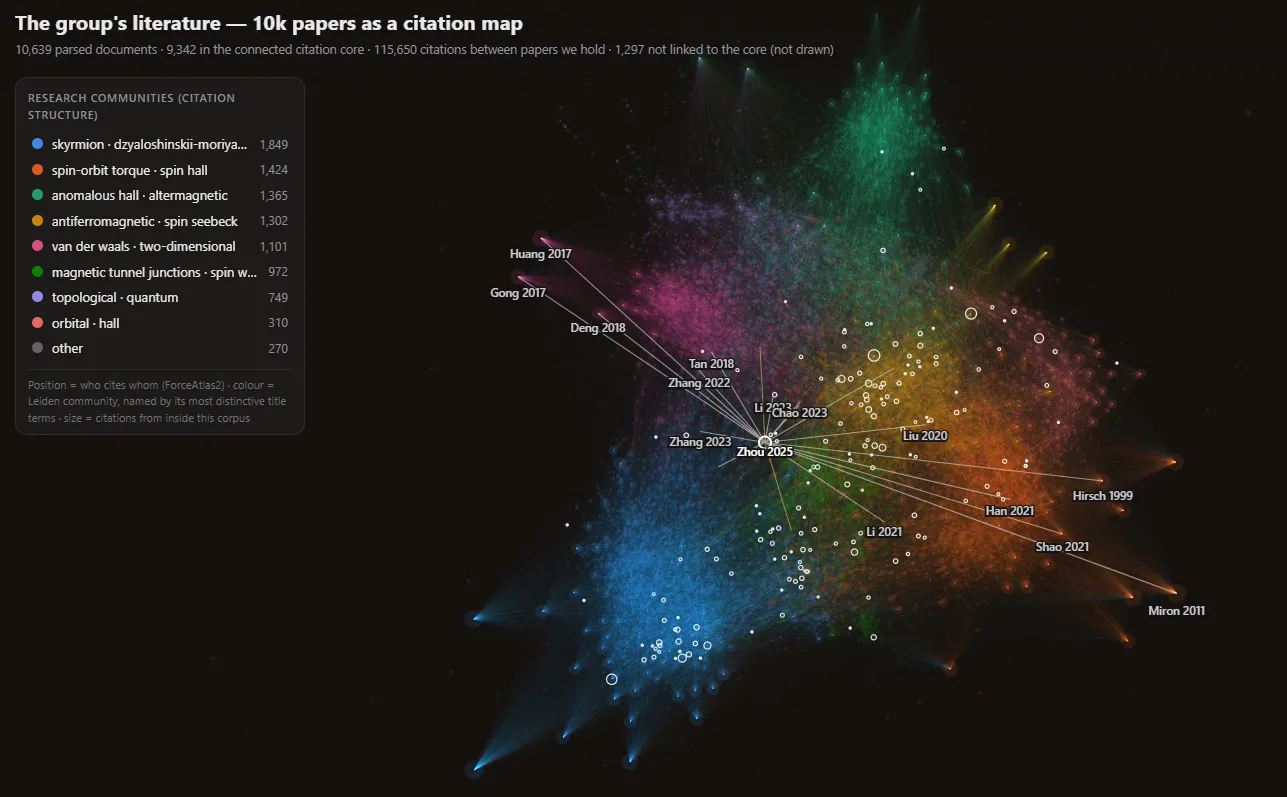 Der Zitationsgraph, durch den der Agent wandert: die Position folgt daraus, wer wen zitiert, die Farbe aus den Forschungsgemeinschaften darin.
Im Betrieb zusammen mit der Suche im internen Wiki der Gruppe. Ein Agent, der sich über eine längere Aufgabe selbstständig durch die Literatur arbeitet, ist nicht gebaut. Die Ergebnisse habe ich auf der AI4Sci 2026 vorgestellt; der Code ist noch nicht öffentlich.